AIエージェント在りし今、ORMは窓から投げ捨てろ
Codexでの一連の作業(Drizzle ORMを除いてSQLだけを使うようにした)を振り返り、煽り記事をAIに書いてもらいました。読みにくいと思うので、AIに要約させてください。どうぞ!
AIエージェント在りし今、ORMは窓から投げ捨てろ
ORMを使う理由のかなりの部分は、「SQLを人間が安全に書き続けるのはつらい」という現実への対処だった。
テーブル定義から型を作り、条件を組み立て、プレースホルダーを管理し、結果をアプリケーションの型へ変換する。変更のたびにSQLとTypeScriptの整合性を人間が確認するくらいなら、その面倒をライブラリへ押し込んだほうがよい。これは長い間、きわめて合理的な判断だった。
しかし、コードベースを横断してSQL、型、テスト、ドキュメントを同時に更新できるAIエージェントが実用になった今、その前提は少し変わったのではないか。
今回、SvelteKitをCloudflare Workers上で動かし、TiDB Serverlessを永続化先とするアプリケーションからDrizzle ORMを段階的に撤去した。結論から言えば、ORMが担っていた安全性を捨てたわけではない。安全性を「production実行時の抽象化」から「SQLスキーマ、明示的な型、実DBを使う契約テスト、エージェントの作業規約」へ移した。
この記事では、なぜ撤去したのか、AIエージェントが何を変えたのか、実際にどの順序で移行したのか、そしてエージェントへどのようなルールを与えたのかをまとめる。
ORMを外したかった理由
発端は、認証済みリクエストのたびに呼ばれる getUserFromId だった。この関数はセッション内のIDから利用者を取得するだけだが、そのためにORMを経由していた。
ORMと直接SQLの差をローカルで測ると、劇的な差ではない。ネットワーク越しのDBアクセスでは通信時間のほうが支配的になりやすく、ORMだけを外せば何十ミリ秒も速くなる、という話ではなかった。
それでも、このアプリケーションの実行環境はCPU時間を意識する必要があるCloudflare Workersだ。ローカルでは誤差に見える処理でも、productionでは1ミリ秒前後の差になる可能性がある。しかも getUserFromId は一部の重い管理処理ではなく、広い範囲のリクエストが通る経路にある。小さな固定費ほど、ホットパスでは無視しにくい。
もう一つの理由は、コードベースを調べるとORMの高度な機能をあまり使っていなかったことだ。すでに生SQLが混在し、複雑な集計や認可条件はSQLで表現していた。ORMは永続化層全体を統一する中心的な抽象化というより、単純なCRUDの一部を包む依存になっていた。
そして、実際のシステム開発では、アプリケーションコードの外でSQLを直接扱う場面がまだなくならない。遅い処理の原因を調べるためにproduction相当の環境で実行計画を見る。問い合わせや障害対応のために、条件を変えながらデータの状態を確認する。migrationの前後で件数や不整合を調査する。こうした作業では、最終的にDBへ流せるSQLが必要になる。
ORMを使っていると、アプリケーション上のクエリを調査用のSQLへ翻訳し、生成されたSQLとbind値を確認し、DBクライアントで再現できる形へ組み直す手間が生じる。単純なクエリなら大きな問題ではないが、JOINや動的な条件が増えるほど、普段読んでいるコードと調査時に扱うSQLとの距離が広がる。直接SQLで実装しておけば、アプリケーションが何をDBへ要求しているかがコード上で明らかで、調査の出発点となるSQLもすぐに得られる。もちろん実環境では権限や負荷に配慮し、必要ならread replicaや検証環境を使うべきだが、調査の共通言語がSQLであること自体は変わらない。
さらに、小さいが無視できないのが、ORMそのものを選び、追従し続けるコストである。新しいプロジェクトでは、型安全性、migration、対応DB、edge runtimeへの適合性、bundle sizeなどを比較してORMを選ぶ必要がある。しかし、採用時には勢いがあったライブラリでも、開発が滞ったり、必要なDBやruntimeへの対応が進まなかったりすることはある。そのたびに別のORMへ乗り換えるべきか悩み、乗り換えるなら独自APIで書かれたクエリやスキーマ定義を移植しなければならない。
ORMもまた依存パッケージなので、脆弱性情報を監視し、必要に応じて更新し、その変更が生成SQLやmigrationへ影響しないか確認する必要がある。もちろん、直接SQLにしてもDB driverなどの依存とその脆弱性対応は残るため、保守がゼロになるわけではない。それでも、十分に活用していない抽象化のために、選定、更新、移行というライフサイクルをもう一層抱えることは、このアプリケーションでは割に合わないと感じた。
つまり、負担しているものは次のようになっていた。
- Worker bundleへ入る依存と初期化コスト
- ORMのスキーマ定義と実DBスキーマを二重管理するコスト
- 生成されるSQLを推測または確認する認知負荷
- 性能調査やデータ調査のたびに、ORMの記述を実行可能なSQLへ翻訳する手間
- ORMの選定、開発状況への追従、停滞した場合の乗り換えを検討するコスト
- ORMパッケージの脆弱性対応と、更新による影響を検証するコスト
- 生SQLとORMが混在することで生じる二つの流儀
一方、得ていた恩恵は限定的だった。このバランスなら、直接SQLへ寄せる実験には十分な理由がある。
AIエージェントが変えたのは「SQLを書くコスト」だけではない
手書きSQLへの典型的な反論は正しい。列名を間違える。引数の順序を間違える。nullableな列をnullableでない型として扱う。mutationの件数を確認し忘れる。transactionの途中で別connectionを使う。そして、スキーマ変更とクエリ変更が簡単にずれる。
AIエージェントも、放っておけば同じ間違いをする。むしろ大量のコードを短時間で変更できるため、規約がなければ間違いを広範囲へ複製する危険がある。
重要なのは、AIがSQLを生成できることではない。AIに次の一連の作業を毎回要求できることだ。
- 正本のSQLスキーマを読む
- クエリと専用の結果型を同じdata-access moduleへ置く
- 実TiDBへクエリを流す
- 返却列、JavaScript上の型、nullability、件数を検査する
- mutation後の値を読み戻す
- transactionのcommitとrollbackを試す
- typecheck、test、lint、production buildを通す
- 実装と同じ変更で設計・運用文書を更新する
以前なら、この確認をすべて手作業で続けるコストがORM導入の強い根拠になった。AIエージェントは、その反復コストをかなり引き下げる。ORMが不要になる可能性は、「AIなら正しいSQLを書ける」ことよりも、「面倒だが機械的に検証できる作業を、変更のたびに完遂させられる」ことから生まれる。
型安全性をproductionのCPUで買わない
直接SQLへ移行するとき、最初に悩んだのは結果行の型だった。DBドライバの返却値を as unknown as UserRow[] と書くだけなら簡単だが、根拠のない二重castは単なる願望である。
かといって、productionの全リクエストで汎用schema validatorを使い、全行をparseするのも今回の目的に合わない。そもそもの動機がWorkerのCPU負荷とbundleを小さくすることだからだ。
そこで、安全性を事前検証へ移した。
export type MemberByIdRow = {
  id: number;
  email: string;
  n: string | null;
  role: string;
  groupId: number | null;
  disabled: number;
};
各クエリには、選択する列とaliasに正確に対応した名前付きrow型を定義する。DB結果のcastは、そのSQLを所有するserver-onlyのquery module内だけで許可する。そして対応する契約テストで、実TiDBが返す次の内容を確認する。
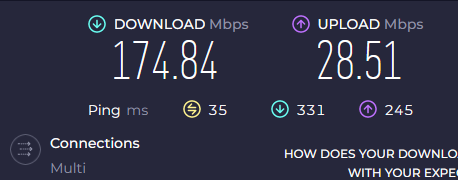
 は、無料期間が終わったときに解約していましたが、再度契約してみました。
縛りがなくてすぐに解約できますし、通信量制限も取り払われたようなので。